같은 "AI"라는 단어를 쓰면서도 사람마다 머릿속에 그리는 모습은 전혀 다릅니다. 누군가에게 AI는 가끔 검색 대신 물어보는 채팅창이고, 누군가에게는 하루 종일 코드와 보고서를 같이 쓰는 동료입니다. 회의에서 "AI로 이거 되나요?"라는 질문에 답이 엇갈리는 이유가 여기에 있습니다.
이 간극을 숫자로 그려 보인 글이 지난주 큰 반향을 일으켰습니다. 전 OpenAI 창립 멤버이자 전 Tesla AI 책임자인 안드레이 카파시(Andrej Karpathy)가 "LLM 능력에 대한 공통 이해의 격차가 벌어지고 있다"고 주장한 X 게시물입니다. 이 글은 조사 통계가 아니라 한 전문가의 관찰이자 추정입니다. 다만 "나는 어느 층에 서 있는가"를 돌아보게 만든다는 점에서, 실무자와 교육 담당자라면 한 번 짚어볼 만합니다.
무슨 일이 있었나
- 2026년 10월 11일, 카파시가 X에 글을 올려 세계 인구를 LLM 경험 수준에 따라 네 층으로 나눈 "뾰족한 깔때기(sharp funnel)" 그림을 제시했습니다. 지난 4월에 썼던 글을 다시 정리한 것이라고 밝혔습니다. (출처: 카파시 X 게시물)
- 카파시는 각 층이 보는 "AI가 할 수 있는 것"이 전혀 달라서, 사회 전체가 공유하는 이해의 격차가 점점 벌어지고 있다고 주장했습니다. 근거로는 사람의 검토 속도가 에이전트의 산출 속도를 따라가지 못한다는 점을 들었고, OpenAI의 수학 원고 722건이 검토 대기 중이라고 언급했습니다.
- 이 글은 Hacker News에서 727점, 댓글 1,072개를 기록하며 그 주 가장 많이 논의된 AI 글 중 하나가 되었습니다. (출처: Hacker News)
- Hacker News 상위 댓글에서는 "격차는 모델 능력 자체보다 작업의 검증 가능성을 따라 갈린다"는 반론이 나왔습니다. 코드·수학처럼 맞는지 바로 확인되는 일에서 AI가 먼저 강해지고, 검증이 어려운 일에서는 아직 체감이 작다는 지적입니다.
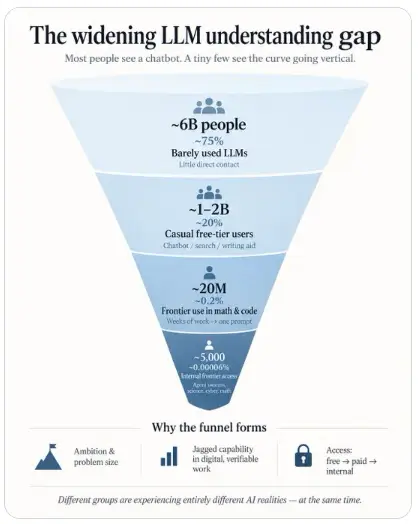
네 층을 표로 정리하면 다음과 같습니다. 모든 숫자는 카파시의 추정입니다.
| 층 | 카파시의 추정 인원 | 카파시가 설명한 사용 모습 |
| 1층 | 약 60억 명 | LLM을 거의 써본 적 없음 |
| 2층 | 약 10~20억 명 | 무료 티어를 가볍게 사용 |
| 3층 | 약 2,000만 명 | 프론티어 모델을 수학·코딩 등 전문 작업에 사용 |
| 4층 | 약 5,000명 | 공개되지 않은 프론티어 시스템에 내부 접근 |
쉽게 풀어보면
쉽게 풀어서 얘기하자면, 카파시는 AI를 둘러싼 논쟁의 축이 "AI가 어디까지 하느냐"에서 "당신이 어떤 AI를 어떻게 써 봤느냐"로 이동하고 있다고 보는 것입니다. 같은 기술을 놓고도 무료 채팅창만 써본 사람과 최신 모델에 복잡한 작업을 맡겨본 사람은 전혀 다른 결론에 이르고, 그래서 "AI는 과장이다"와 "AI가 일을 바꾸고 있다"가 동시에 진심일 수 있다는 설명입니다.
반론도 설득력이 있습니다. Hacker News 댓글이 지적했듯, 체감의 차이는 "누가 더 강한 모델을 쓰느냐"보다 "그 일의 결과를 바로 검증할 수 있느냐"에서 더 크게 갈릴 수 있습니다. 코드는 실행해 보면 맞는지 알 수 있지만, 고객 응대 문구나 전략 보고서는 틀렸는지 한눈에 드러나지 않습니다.
같은 주의 다른 논의도 비슷한 지점을 짚습니다. Rich Hickey는 10월 12일 글에서 LLM은 도구가 아니라 자동화이며, 읽기와 쓰기를 통째로 맡기면 배움과 판단력을 잃는다고 주장했습니다. 이에 대해 Huahai는 컴파일러와 스프레드시트도 자동화였지만 결국 도구로 자리 잡았다며, 핵심은 숙련된 사용과 무비판적 위임의 차이라고 반박했습니다. 카파시 역시 10월 2일 글에서 모델 출력을 단순한 글 → 다이어그램 → 인터랙티브 HTML → 설명 영상처럼 점점 소화하기 쉬운 형태로 받으라고 제안한 바 있습니다. 세 글을 겹쳐 보면, 공통 병목은 모델이 아니라 "사람이 얼마나 빨리 이해하고 검증하느냐"에 있는 것으로 보입니다.
Implication
- 같은 조직 안에도 AI 경험의 층이 섞여 있어 "AI로 되는지"에 대한 판단부터 어긋납니다. 도입 논의 전에 구성원이 어느 층에 서 있는지 확인하는 것이 먼저입니다.
- 격차는 모델 능력보다 "결과를 검증할 수 있는가"를 따라 벌어집니다. 검증이 쉬운 일(코드·계산·데이터 정리)부터 맡기고, 검증이 어려운 일은 사람이 마지막 확인을 하는 분업이 효과적입니다.
- 카파시가 지적한 "검토 속도가 산출 속도를 따라가지 못한다"는 문제는 조직 안에서 먼저 나타납니다. 도구보다 검토·승인 절차와 검증 역량을 먼저 갖춰야 산출물이 실제 성과로 이어집니다.
- 교육의 초점은 "AI가 무엇을 할 수 있는가"에서 "결과를 어떻게 검증하는가"로 옮겨가야 합니다.
지금 해볼 수 있는 것
- 내 위치 확인: 지난 한 달 동안 어떤 모델을, 어떤 작업에, 얼마나 썼는지 적어 보고 카파시의 네 층 중 어디에 가까운지 가늠해 봅니다.
- 업무를 검증 난이도로 분류: 팀 업무를 "결과를 바로 확인할 수 있는 일"과 "확인이 어려운 일"로 나눕니다. 전자부터 AI를 적용하고, 후자는 검토 규칙을 먼저 정합니다.
- Huahai가 제안한 습관 적용: 낯선 코드나 문서를 AI에게 설명하게 하고, 그 설명에 반박해 보고, 직접 원본을 확인하고, 제안된 변경을 테스트한 뒤 거절하거나 수정합니다.
- 출력 형태 바꿔 보기: 카파시의 제안처럼 긴 글 대신 표, 다이어그램, 인터랙티브 페이지로 결과를 받아 검토 시간을 줄여 봅니다.
- 검토 병목 측정: AI 산출물이 승인까지 걸리는 시간을 재 봅니다. 이 숫자가 줄지 않으면 도구를 늘려도 효과가 적습니다.
한 줄 정리
카파시의 말대로 격차가 벌어지고 있든, 반론대로 검증 가능성이 가르든, 해야 할 일은 같습니다. 직접 써 보고, 결과를 검증하는 힘을 기르는 것입니다.
누가 옳은지보다 중요한 것은 내 업무가 지금 어느 층에 있는지 아는 일입니다. 출발점은 거창한 도입 계획이 아니라, 이번 주에 업무 하나를 골라 직접 맡겨 보고 결과를 검증하는 작은 실험입니다.
기업 교육, 강의, AI 업무 자동화에 관심 있는 분들은 언제든지 이메일이나 오픈채팅방을 통해서 문의 남겨주세요.
이메일 문의: contact@upflash.co.kr
카톡 오픈채팅방 문의: https://open.kakao.com/o/s4zCZdAi
#업플래시 #ai교육업플래시 #ai교육업플래시차경훈대표 #ax컨설팅업플래시차경훈대표 #바이브코딩업플래시차경훈대표 #클로드강의업플래시차경훈대표 #클로드과외업플래시차경훈대표